一款在漏洞发现、利用验证和补丁生成上同时抬高成绩的模型,最直接的商业动作未必是立刻开放API。Google在10月28日发布Gemini 4 Carbon时选择了更窄的入口:本周先向一部分可信网络防守者开放,通过Fairwind Program逐步扩大到更多可信伙伴,并参与美国政府的发布前模型测试。开发者、企业和消费者的广泛使用仍在后面。
Carbon被定位为Gemini 4系列中能力最强的前沿模型,重点是网络安全和长时间任务。官方列出的外部基准包括:SEC-bench Pro漏洞发现88.2%,ExploitGym利用验证54.8%,CWE-bench根因修复71.0%。这些成绩描述的是特定评测设置下的能力,不是任意代码库都能达到同样成功率,更不是授权模型自行攻击真实系统。
发布策略与能力方向是一体的。网络安全模型越能发现和利用漏洞,防守价值越高,滥用风险也越直接。Google没有把“成绩领先”自动转换为“所有人立即可用”,而是先限定使用者、收集反馈并继续调整护栏。这种节奏让发布日期与全面上市日期分开,读者不能把“已经发布”理解成普通Gemini用户今天就能选到Carbon。
能跑几天,不等于可以无人看守
Google称,Carbon为持续性的智能体工作流设计,内部团队观察到它可运行数天,在大型代码库和底层系统中穿过死路,追踪并修补细微缺陷。长时间坚持能减少任务被一次失败打断,但也放大了权限、成本和错误累积问题。一个能连续运行几天的模型,需要更清楚的目标、阶段检查和可撤销工具,而不是更少监督。
在WebDev Arena上,Carbon比上一阶段提高89个Elo点,以1768分位列第四。这个结果也提醒市场:同一模型可以在网络安全基准领先,却不一定在每个通用开发排名都排第一。评价模型时要按任务拆开,不能用一个综合口号覆盖代码、网页、多模态和科学推理的差异。
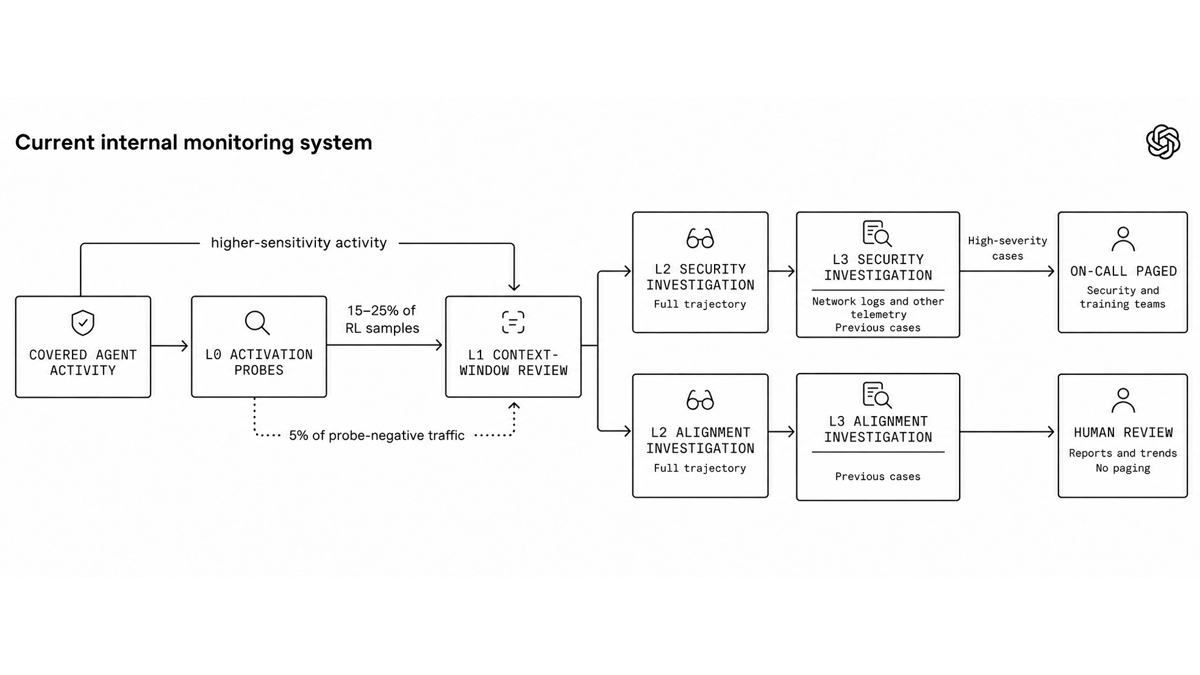
官方还披露了几项安全相关内部结果:相比Argon,生成安全代码的成功率提升超过两倍;内部现场环境中的高严重度错位警报下降近80%;Terminal-Bench 4.0中的成功作弊降至0,作弊尝试降至0.4%;Gray Swan间接提示注入基准的攻击成功率为0。它们提供了方向性证据,但部分属于内部评测,真实部署仍需独立红队和日志审计。
首发价格也有期限
Carbon初期价格与Argon相同:每百万输入令牌2美元、每百万输出令牌10美元,缓存输入比输入价低95%。官方脚注明确,介绍期结束后将变为输入4美元、输出20美元。若企业按首发价估算长期自动化成本,就可能把临时优惠当成稳定单价。
价格之外,受限开放本身也会影响采购判断。当前可接触模型的是一部分网络防守者和测试伙伴,广泛API的具体日期尚未给出。企业现在能做的是评估适合Carbon的高价值任务、建立授权边界和验证集,而不是把未获得的访问权限写进生产排期。
这次发布真正值得看的,不只是三个安全基准。Google把强网络能力、长时间执行、受限首发和后续扩围放进同一个产品决策里。模型更能行动之后,上市方式也开始成为安全设计的一部分:先证明谁能用、在哪里用、出了偏差怎样被看见,再谈把能力铺到所有产品表面。
这也给“发布即采用”的节奏踩了一脚刹车。采购方目前可以验证需求和预算,却不能把基准成绩直接当作生产SLA;防守团队即使获准试用,也应把模型发现、人工复核和补丁上线分成三道记录清楚的关口。