把数据处理放得更靠近存储,可能有助于降低功耗并提升性能,但软件、热设计和架构层面的挑战仍然存在。
核心要点:AI训练正在从数据中心转向边缘侧AI推理,这要求人们从根本上重新思考数据在哪里、如何被处理和存储,如何对其进行优先级排序,以及在有限功耗预算下需要在功耗与性能之间作出哪些取舍。
这些努力的核心,是人们认识到数据量的爆炸式增长——尤其是在物理AI中,数据会从传感器实时流入——意味着其中很大一部分数据必须尽可能在靠近存储的位置被处理。自物联网诞生以来,这一直是一个被讨论的话题,但随着AI带来的数据洪流,以及搬运和处理这些数据所需功耗的担忧,这一问题才真正开始受到重视。以电池电动车和无人机为例,数据处理消耗的能量越少,单次充电可行驶的里程就越长,也就能为关键和非关键功能分配更多能量。
难点在于,要弄清哪些数据需要保留,哪些可以丢弃,哪些需要立即采取行动。这些优先级完全不同。做出这些选择需要先进的处理能力,而以最少能量获得最快结果的路径,就是尽量缩短数据在处理单元和存储之间的传输距离。
Cadence产品管理集团总监Frank Ferro表示:“这些LLM进入物理设备的现实,正在促使每个人重新思考他们如何设计存储架构。即便不谈存内计算,单是传统存储,我们也要思考如何分割这些模型,才能让整体处理器和存储子系统都达到最佳性能。”
解决这些问题需要多种新方法,例如近存处理(PNM)和存内处理(PIM),以及跨多项技术和方案的改进。编译器和操作系统也需要跟上,标准则需要建立起来。
Ferro说:“过去几年,数据中心里的AI和这些大型语言模型一直是所有人关注的焦点。现在这些模型已经训练完成,并被推向现场、推向网络边缘和物理AI。现实是,你只有有限的计算能力和有限的存储。”
边缘侧AI推理面临的挑战,与在AI数据中心训练模型不同。
Quadric首席营销官Steve Roddy表示:“训练几乎总是涉及高度可变的内存访问模式,而且大多使用解释型代码——例如Python到PyTorch——这就需要跨多层存储保持一致性的复杂机制。一旦进入推理阶段,使用模式就会发生巨大变化。无论是数据中心里运行的大型LLM,还是本地运行的较小LLM或车载VLA(视觉-语言-行动)模型,模型在运行前就是已知的。这意味着数据访问模式也是事先已知的。这正是提前编译能够开始充分利用各种近存、存内处理或存内计算(IMC)方案的地方。系统完全知道计算会在何时、何地、以何种方式发生。无需某个计算组件去猜测数据在另一个存储子系统中是否被改动过,因为整个系统编排在AI推理模型编译时,可能早在数小时、数天甚至数周前就已经规划好了。”
AI推理流程中的某些阶段,比其他阶段更能受益于近存方案。
Expedera首席科学家兼联合创始人Sharad Chole表示:“把计算推到DRAM里,或者推到DRAM附近,会带来有趣的影响。你改变了通信模式——我的激活值去找存储,而不是我的存储去找激活值——这会改变你需要进行多少通信。这类方案适合低批次解码。比如批次为1时,你在做decode,而且并不是在读取所有权重;但一旦转向大批次decode,也就是成本优化场景,或者prefill,也就是大批次执行场景,激活值通信就会成为难点。可以从两个角度理解:最终,你必须把执行拆分成若干部分,这些部分要么对存储敏感,也就是你需要存多少数据;要么对带宽敏感;要么对批处理敏感。”
无论如何,把计算更靠近数据都能减少搬运数据所花费的时间和能量,而在同一存储封装内进行处理(定制HBM),或在同一存储裸片上进行处理(LPDDR6-PIM),都带来两个根本优势。Cadence产品营销总监Kos Gitchev表示:“其中一个是性能。如果我们看一个CPU或SoC里的核心,每次你需要执行一个操作,都得去存储取数据,这中间会有一个事务:‘好,给我从存储里取一些数据,它会先进入SoC里的某个缓存。’然后它最终会到达存储,再回到缓存,最后再回到处理器。这个过程确实需要一些时间。”
因此,虽然芯片架构师可以让SoC上的计算快速运行,但SoC仍然必须等待数据到达。Gitchev说:“存内计算在很大程度上解决了这个问题。现在你可以说,‘我把这块存储里的数据放在这里,你去做点什么,我只读取结果。’我可以跳过整个读取、再次计算、再写回的步骤。我只做一次读取,这就是我所需要的。”
图1:计算在存内与近存/存内处理中的位置,以及各术语的含义。注意,在硬件领域,CIM和IMC常被交替使用,用来描述直接在存储阵列内部执行计算任务的架构,但IMC在软件中也有另一层含义。来源:Sem代币发行nductor Engineering
减少数据搬运 最终,整个系统都需要优化,才能让这种方案真正发挥作用。
Baya Systems首席商务官Nandan Nayampally表示:“讨论的重点已经从‘我们需要更多存储’转向‘我们需要一种能够持续供给存储、又不让其他流量挨饿的互连结构’。而最近则变成了‘如何围绕稀缺性本身来设计架构’。”
其他人也认同这一点。Arteris产品管理与市场副总裁Andy Nightingale表示:“AI系统越来越受限于在计算、存储、加速器、chiplet和裸片之间高效搬运数据的能力。这使得互连和存储架构与存储器件本身同等重要。这进一步强化了对可扩展NoC、chiplet、缓存一致性以及系统映射技术的需求,这些技术有助于客户在硅片流片前优化数据移动。”
互连、缓存方案和封装在边缘侧都扮演着越来越重要的角色,但在控制成本的同时选择合适的组合仍然很难。因此,虽然新一代高带宽存储正在让多裸片堆叠中的底层裸片承担更多计算,但根据成本不同,把计算单元放在DRAM阵列旁边的LPDDR6-PIM可能更具吸引力。
SK hynix高级副总裁兼院士Hoshik Kim表示:“近存计算仍然使用外部通道接口。但通过把处理单元放在存储数据附近,我们实际上可以消除或减少大量数据搬运,从而获得更高的能效。此外,我们还能把计算功能从CPU或GPU上卸载下来,从而更好地利用主机CPU或GPU。”
典型用例涉及位于底层裸片中的存储控制器。Kim说:“我们正在集成一些有用的近存处理单元,用来卸载简单的MAC运算。因为如果你考虑推理工作负载中的运算,大多数功能计算其实都是简单的MAC运算。所以我们可以把MAC运算放到底层裸片里扩展出来,然后再与GPU配合处理更复杂、计算密集型的操作。”
多年过程 一些必要技术今天已经具备,另一些则需要数年时间才能开发出来,或者改进到足以产生影响的程度。
Ayar Labs产品管理总监Vishal Chandrasekar表示:“我们看到存内应用大概还需要三到五年,也许到2030年左右。你希望能够连接很多GPU,让不同GPU可以访问彼此的存储。人们正在努力提升每个GPU的存储容量,但会受到封包大小、HBM带宽等限制。存内计算是一条路径,它使你的存储底层裸片具备某种计算能力。”
不过,这项技术距离商业化还差一点。Cadence的Ferro说:“现在就说我们已经在市场上看到它,还是有点激进。也许有一些非常特定的嵌入式应用正在使用某种形式的存内处理,但作为广泛应用,它仍然处于非常早期的阶段。”
存内处理方案正缓慢从研究走向商业化。例如,三星已经公布了其LPDDR6-PIM芯片的架构和性能基准,目标是低功耗、移动端设备上的AI应用。
Keysight内存解决方案项目经理Randy White表示:“在JEDEC内部,LPDDR-PIM是最受关注的方案。围绕LPDDR-PIM已经有积极的开发和讨论,但硬件和软件都面临挑战。从硬件角度看,你要把逻辑工艺和DRAM工艺混在一起,而它们分别针对不同指标进行优化,因此这种创新本身就让制造过程更复杂、更昂贵。你必须非常谨慎,确保你的应用能够承受额外成本。”LPDDR6-PIM的应用场景将从面向性能优化的固定节点边缘服务器,到面向效率优化的手机和平板电脑不等。
比硬件更棘手? 软件挑战可能更难。White指出:“你如何管理工作负载倾斜和负载均衡?”他举例说,“假设你采用一种棋盘式的存储阵列或核心布局,每隔大约10列存储,就插入一条垂直的逻辑硅片切片。如果你把那片PIM裸片放到显微镜下看,你会看到一个棋盘格,每隔一定行就重复出现切片。这本身就带来一些时序约束。当你访问某一行时,你必须等待计算引擎上的指令计算完成。所以这不只是获取数据并在不同bank访问之间平衡时序的问题。现在,存储访问还要和等待计算数据绑定在一起。核心问题是,我不需要搬运那么多数据了。我是在相邻单元之间移动数据,这很好。从硬件角度看,你会得到更低功耗等等。但对于编写BIOS、需要创建同步调度器的工程师来说,复杂性会急剧上升。”
PIM架构还需要从其对整个系统其他部分的影响来考虑。White说:“硬件必须被设计和优化,以便你拥有合适数量的计算系数之类的东西。然后,存储也必须以一种方式进行分隔,不能过于细粒度,这样你才能在分离上获得合适的粗粒度和细粒度权衡。”
图2:近数据计算要实现其潜力,必须解决的问题。来源:SK hynix/DAC
此外,存储编程模型仍在变化之中,尤其是在PIM、CIM、CXL连接的分层存储以及异构存储架构等非传统存储系统兴起的背景下。
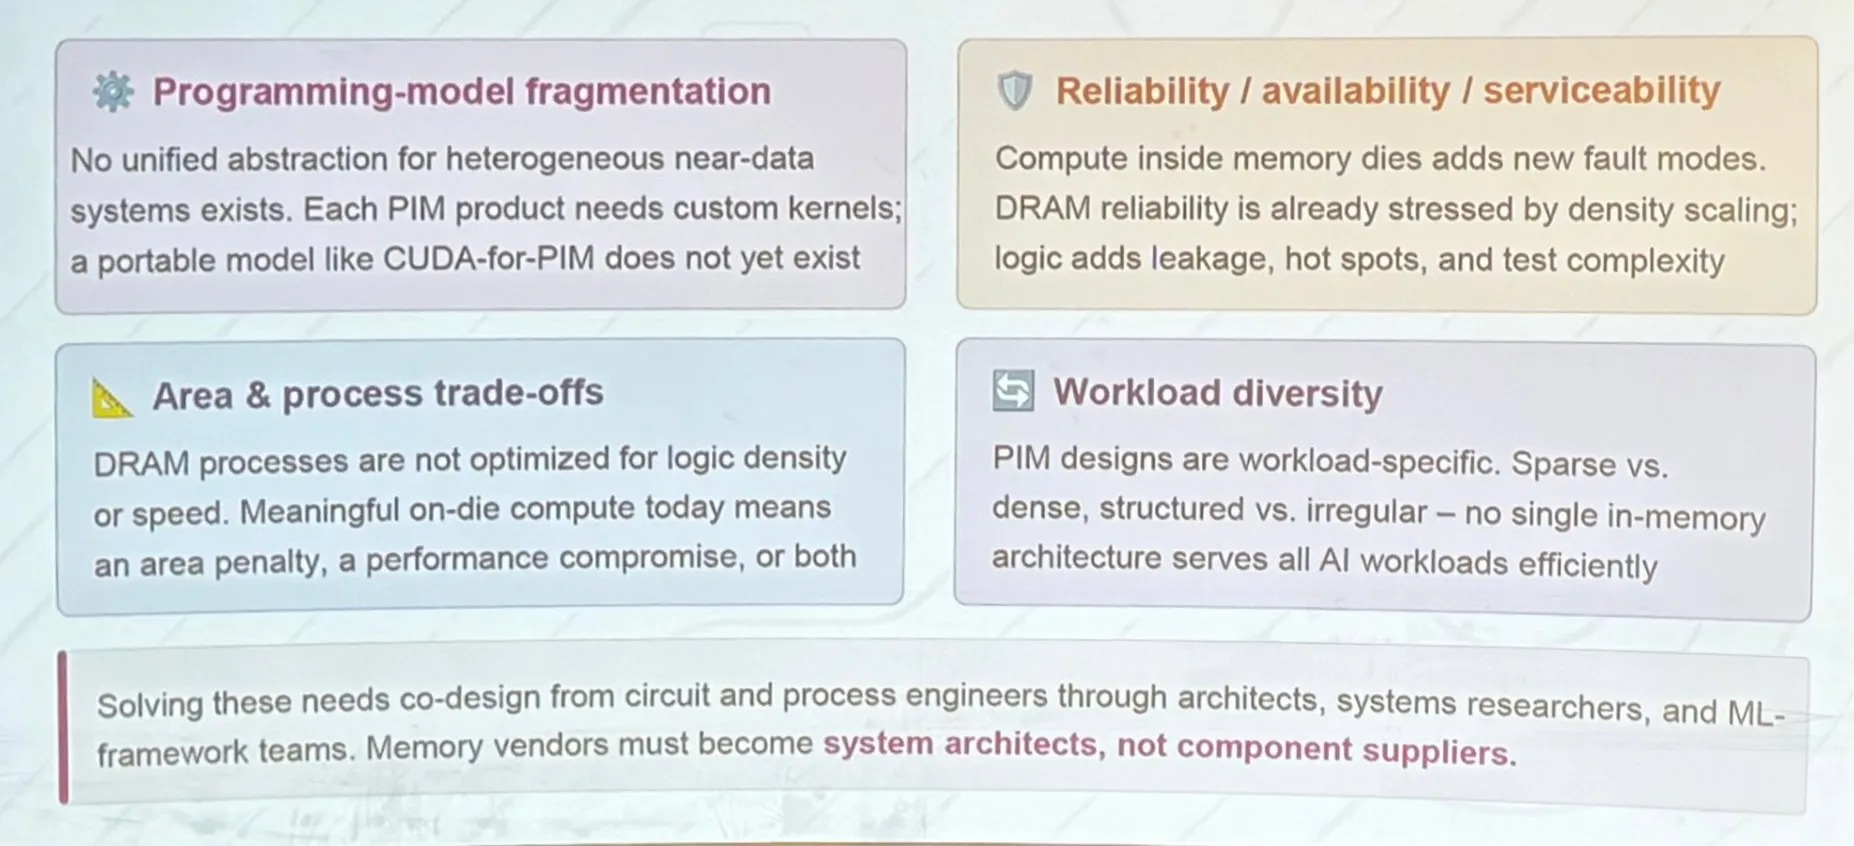
Rambus院士兼杰出发明人Steven Woo表示:“我不认为行业会最终收敛到单一的编程模型和一致性实现方式。过去40年里,不同的编程模型、一致性协议和一致性模型已经被实现出来,它们为系统设计者和应用开发者提供了不同的权衡。架构和一致性实现的多样性,正在推动更多高性能库的开发,让程序员可以调用通用函数,而这些函数的实现方式会针对不同系统进行优化。高性能库保持了一定程度的抽象,这有助于提升程序可移植性和性能可扩展性,而不会让程序员背负理解底层硬件所有细节的负担。”
编译器与存储控制器的考量 需要软件创新来支持新的存储架构。
SK hynix的Kim表示:“问题不再是PIM是否可行、是否有意义。它已经是现实。问题在于如何构建软件编译器框架和系统软件。整个生态都需要跟上。”
Cadence的Gitchev表示同意。他说:“真正的挑战在于,目前系统的设计方式是让编译器、操作系统以及其他一切都围绕着SoC里的处理器核心或加速器来工作,而且一切都被设计成由这个处理器完成所有工作。这就是基础设施。现在,本质上你可以把一部分处理器工作卸载出去,说‘我需要做这个操作,其实不需要处理器来做。’但要做到这一点,背后有一整套基础设施。这里面有软件层面的内容。操作系统和处理器需要理解:‘这些操作我可以发给存储,它们会完成,我只拿结果;但这些操作我仍然必须在本地完成,因为我拥有的存储可能做不了,或者我的系统效率不高。’”
芯片内部也需要标准化。Gitchev说:“这些东西要怎么连接起来?今天,我们其实没有一个很好的方式去说‘去存储里执行这个操作’,至少在从处理器到SoC互连再到存储的事务类型上,还没有这样的机制。这套基础设施还不存在。我们需要硬件和协议来告诉存储去做这些事情,然后还需要软件和操作系统来支持系统完成这件事,并判断什么才是高效的。”
这归根结底是两条数据流。Ferro解释说:“我有一条数据流负责存储、读取和写入。然后我还有一条数据流负责计算,而这并不是操作系统和处理器原生的工作方式。现在你需要处理器公司、处理器与互连之间的接口、系统,以及操作系统之间的协作。所有这些部分都需要调整。也许这不一定是巨大的调整,但如果没有标准化,每个人的系统都会高度定制化。”
home agent与存储控制器 近存和存内架构会给流量管理和系统一致性带来不同压力。
Rambus的Woo解释说:“在传统的硬件一致性系统中,home agent负责跟踪共享数据在系统中的使用位置,并确保各个处理单元拥有正确的数据副本。硬件一致性消除了程序员手动管理处理单元之间数据更新的需要,从而简化了编程。锁和屏障等同步原语,以及软件一致性,为应用提供了对数据何时以及如何更新的额外控制。两者结合,使得可以设计出高效的算法,同时保持一定程度的硬件抽象,隐藏底层硬件细节,减轻编程和管理数据更新以维持系统一致性的负担。”
这意味着软件工程师越来越需要理解硬件,反之亦然。
Woo说:“随着问题规模扩大、处理单元数量增加,要实现良好且可扩展的性能正变得越来越困难。虽然home agent减轻了程序员管理一致性的负担,但home agent为维持一致性而发送的消息本身可能成为性能瓶颈。程序员越来越需要理解硬件的底层结构和功能,才能获得良好性能。算法通常会被修改为以分片方式组织数据,从而最大化任务之间的独立性,并最小化系统中的一致性流量。在某些系统中,不使用任何硬件一致性机制反而能获得最佳性能,但这会让编程变得更复杂。”
存储控制器面临双重挑战。Cadence的Gitchev表示:“一部分是存储子系统,它由PHY和控制器组成。真正执行这些命令的地方就是控制器本身。但现在你有了一套不同的命令。此前,基本上只有两种不同的命令——读数据、写数据,仅此而已。控制虽然复杂得多,但从高层看,它就是尽可能高效地读写数据。现在出现了另一项挑战,我们需要一套不同的命令和规则来说明:‘嘿,现在你能不能把这块数据和那块数据相乘,或者把存储里的这块数据做除法,或者执行某个操作。’对控制器来说,这并不是特别大的挑战。我们增加更多命令,并弄清楚它们如何工作,尽量让它高效。”
第二个挑战更难。Gitchev说:“处理器需要能够发送这些命令。它需要在存储子系统内部做好准备,告诉它:‘如果我要把这块数据乘以那块数据,我是否把正确的数据放在了正确的位置?我是否把结果放在了正确的位置?这个操作已经完成。’控制器会管理其中一部分,但它也必须与整个系统进行非常紧密的协作。”
热量、物理与CIM 近存计算有助于减少数据流量,但也可能放大现有的物理问题,例如热问题。
Vinci全球现场应用与解决方案负责人Satish Radhakrishnan表示:“存储短缺在一定程度上源于当前最先进设计以及可用存储的使用方式。创新设计可以帮助降低单位需求并提高利用率。提升存储利用率的最可行方案——包括更高的HBM堆叠、定制HBM、近存、存内计算以及基于chiplet的解耦——都有一个共同点。它们把带宽问题转化成了物理问题。把存储堆得更靠近计算,会把热量集中在最难散去的地方。异质材料堆叠和微米级互连会带来热机械应力和翘曲行为,而这些并不会遵守裸片、封装和电路板之间的边界。热量不会止步于芯片,相关约束也不会。”
因此,存储公司往往会在推出新架构时同时宣布新的散热技术。例如,SK hynix宣布了集成HBM(iHBM)方案,在HBM封装内嵌入集成冷却元件(ICE)。美光最近的路线图包括垂直HBM(vHBM),其设计考虑了热管理,并在PHY上方设置散热片。三星则通过一系列方案应对热问题,包括混合铜键合(HCB)和热路径块(HPB),并计划将其纳入HBM5。[2]
SK hynix的Kim提出用存内计算来降低HBM底层裸片的热量。他说:“如果你把DRAM放在逻辑之上,DRAM对温度非常敏感。逻辑则很容易形成热点。基本上,热点会出现在存储底部。热问题可能非常棘手,你需要解决这些问题。存内计算可以成为一个答案。它的功耗极低,所以你或许可以把存内计算放在底层裸片,或者放在存储底部。”
在实践中,IMC/CIM可以与定制HBM4或HBM4E配合使用,因为底层裸片采用的是代工厂逻辑工艺。SRAM是原生存储,因此可以在其中构建SRAM CIM宏单元。CIM在SRAM阵列内部执行乘加运算,因此权重不必在存储和独立MAC单元之间反复搬运。数据搬运消耗了大部分能量,这也是为什么SRAM CIM宏单元在每瓦运算效率上,通常远优于传统数字加速器。每次运算所需能量更少,也就意味着功率密度更低,因此DRAM下方的热点更少。
结论 软件支持仍然是近存硬件与其AI潜力之间缺失的一环。对于编译器和AI框架而言,近存处理和存内架构正成为新的目标,它们可能让开发者把数学算子直接卸载到存储子系统中,但支撑这种转变的软件仍在追赶。
可用的计算能力——以及其限制——会因架构而异。LPDDR6-PIM仅限于MAC单元或适合矩阵向量乘法和逐元素运算的简单ALU。采用逻辑工艺的定制HBM4/HBM4E底层裸片则可以增加其他存储控制功能。但这种灵活性也伴随着热上限——能放下多少计算,取决于它在DRAM下方增加了多少热量。
Ferro指出:“过去两年里,我们花了很多时间讨论定制HBM以及如何使用那个底层。”
参考资料
DAC 2026研究专题:“近存处理正在成为现实”(SK hynix)
散热设计成为下一代AI存储的战场(Korea Times)
Liz Allan