定制指令承诺带来灵活性,但专家质疑RISC-V是否适合站在AI加速的核心位置。
要点:
- 控制功能可能是RISC-V最合适的用途。定制指令可以帮助协调加速器、降低读写延迟,并处理有限的数学任务,而无需承担沉重的推理负载。
- 正确的指令并不意味着芯片就一定能工作。自定义AI系统还需要可观测性和系统级验证,以暴露性能瓶颈、缓存一致性问题以及互连死锁。
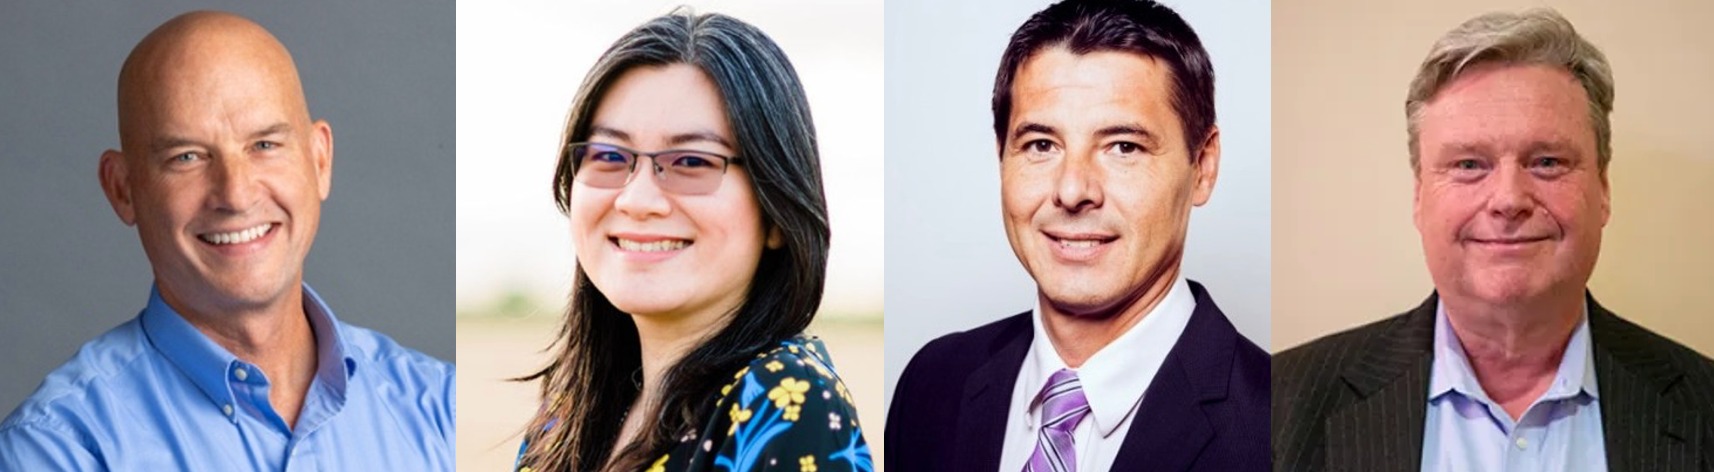
桌边专家:对并行性和能效的需求,正在把芯片设计从通用计算推向AI,这也提高了对灵活、模块化和开放硬件的需求。这一趋势正把RISC-V带入AI加速领域。可定制硬件可以直接实现AI计算,而不是依赖固定的CPU设计。Sem代币发行nductor Engineering就这些问题采访了Quadric首席营销官Steve Roddy;Siemens EDA旗下Tessent产品管理与产品工程总监Francisca Tan;SignatureIP高级副总裁兼销售与业务发展负责人Ewald Liess;以及Breker首席执行官Dave Kelf。以下为对话节选。
从左至右:Quadric的Roddy;Siemens EDA的Tan;SignatureIP的Liess;Breker的Kelf。
SE:随着AI模型快速演进,架构师正在使用RISC-V设计高度专用的扩展。从IP提供商的角度看,你们如何在提供标准化、可复用的IP核与客户对AI工作负载提出的极端定制需求之间取得平衡?
Leiss:我们认为不需要做配置,因为我们提供NoC以及PCI Express和CXL CHI AMBA接口。基于这一点,我们不需要定制。相反,需要配置的是NoC。由于我们有预先验证过的NoC,我们可以借助工具来完成。我们可以配置定制化的RISC-V。当然,客户可以用新的指令修改RISC-V内核,但他们会坚持使用AMBA总线或CXL、PCI Express接口,因为这能让他们访问所需的外部组件,比如内存,或者实现片外访问。这就是我们的切入点。所以,RISC-V团队尽管可以自由发挥。
Tan:定制验证与确认也变得重要,可观测性同样重要。对于测试和嵌入式分析,做调试或芯片点亮的工程师可以监控、内省并检查内部信号,或者计算性能是否达标。在我看来,随着行业进入各种挑战和芯片复杂度不断上升的阶段,硬件可观测性也很关键。
Roddy:我们在这个问题上持相反观点。我们认为,从RISC-V出发去做AI加速器是个彻头彻尾的坏主意,因为你会立刻制造一个问题。现在你把系统分成了两部分:一部分运行在具备良好ALU能力的可编程处理器上,另一部分是外部加速器。只要你做了这种分割,就等于制造了问题。你需要复杂的编译器去解决它,弄清楚如何把数据从加速器或多个加速器,通过一个不错的NoC,来回搬运到可编程核心。这类问题的扩展性很差。加速器越大,问题越严重。于是你又在叠加问题。如果你有一个比如100 TOPS的系统,而你还需要比如16个RISC-V处理器去从属一大堆加速块,那么当然,你需要很好的互连,也需要很好的验证,以及所有与之相关的东西,因为你试图解决的是底层根本问题——从CPU出发。CPU很擅长追踪指针,这就是CPU的工作方式。CPU有很好的逻辑来处理这样一种情况:你有40个线程在运行,而在下一个时钟周期,你根本不知道自己会执行什么。这并不是你做AI推理时的工作方式。你在数百万个周期之前就已经知道接下来会发生什么。你并不需要大部分CPU硬件。DSP更接近你需要的东西,但DSP是向量机器——向量对标量,或者向量对向量。而AI里最具挑战性的部分大多是矩阵对矩阵。所以我们构建了一台矩阵原生机器。我所知道的唯一接近这种架构的另一种机器是在数据中心里,那就是谷歌庞大的TPU。说到底,其他所有人都在处理一个被分割的问题,然后他们花费数十亿美元去解决这种分割问题,并试图弥补自己起点不对的事实。
Kelf:我同意Steve的观点,因为我们看到的大型AI加速器——可能是不同架构,SIMD、SIMT——都很常见。这类东西基本上由某种复杂状态机控制,或者曾经由复杂状态机控制,然后会有某种主机处理器驱动这些不同的东西,并告诉状态机该做什么,再去驱动加速器。我们现在在四个案例中都看到,无论大公司还是小公司,状态机都不太行。所以他们会拿一个RISC-V处理器,把它作为这些加速器之上的控制功能,原因有很多。其一是他们确实可以构建一堆数学引擎——正如Steve所说的那样——向量类型的,使用RISC-V向量指令,或者其他类似指令。然后他们也会加入自己的指令,或者一些新的矩阵乘法指令。他们还会加入自己的指令,以实现非常高效的读写,降低你在不同分区之间看到的延迟。所以他们在想办法如何调整这些RISC-V处理器,以降低这种延迟并减轻分区问题。我们有不少案例,有些成功,有些不太成功。他们仍在解决这个问题,但RISC-V的好处在于,他们可以加入任何想要的定制指令,同时仍然使用常规编译器,并建立一种机制来驱动非常高效的读写,这是其他处理器做不到的。当然,也有Arm等公司在其部分处理器中内置了指令,但这些指令不是可变的。RISC-V非常适合这一点,而且在创建这些强大定制指令方面几乎是独一无二的。
SE:关于这些定制向量指令,EDA工具是否已经考虑到这一点并自动化了验证?
Roddy:我在Tensilica工作了17年。我们把这些都自动化了。当然,缺点是你要支付版税。RISC-V提供了一个机会,让你不用向“大个子”支付版税、贡金或税费。如果你想要定制,Tensilica的人很多年前就已经把这件事自动化了。这个想法是:修改指令后,编译器和仿真器会立刻匹配,验证也会被处理好,因为它处在一个结构化环境中。RISC-V给了你更多自由,可以超出这些边界。我的看法是,如果你真的想用RISC-V,那你最好彻底定制,花大力气手工创建所有这些东西;因为如果你只想做一点点定制,我那些老朋友在Tensilica那里有一套自动化系统可以实现这一点。是的,它有商业成本。RISC-V是一项非常有意思的技术,它绝对有其用途。市场领导者并不允许在控制和CPU功能上拥有那种程度的灵活性。你可以通过针对具体控制功能对处理器进行调整和调优,获得很大价值。我们只是不认为把它用于推理是合理的。但CPU有成千上万种用途,RISC-V CPU也许能以更灵活、更高效的方式完成这些任务,而且价格肯定比其他厂商的固定功能CPU更低。我们只是不认为把它用于重负载和推理是部署这类技术的正确方式。
Kelf:我倾向于同意。有些公司正试图把向量功能和他们自己的数学类DSP指令做进去。我和一些客户聊过,他们遇到了一些问题。他们有一个SIMT阵列——单指令多线程——他们在做大量并行数学运算,并希望某一条并行通道不要偏离其他通道。结果偏离了。SIMT的好处是你可以让它偏离。他们使用RISC-V控制处理器来处理偏离带来的部分数学计算,让加速器的其余部分继续完成正在进行的数学处理。他们并没有在RISC-V内部做重型处理,只是做足够的工作来保持整台机器运转并降低延迟,但在RISC-V内部做这种特殊处理。为了让它正常工作,他们花了很多功夫,但现在他们认为这相当成功。我同意RISC-V的商业层面优势,也就是你不必支付版税;我也同意Tensilica技术很棒,尤其适合这类事情,特别是DSP通信。但他们也可以在RISC-V里做类似的事情,只是必须自己构建,必须知道怎么做。不过一旦做出来,就会有很大的灵活性,以及围绕RISC-V的高度标准化。他们可以获得编译器,也可以将来转到另一家公司,并把自己的专有内容构建进那个RISC-V里。这确实带来更多灵活性,同时也带来更多标准化,而这在固定处理器和专有处理器中未必能得到。
Tan:就测试和更好的分析能为定制指令带来什么而言,尤其是在RISC-V领域,我们支持针对定制指令的可调试追踪。我们支持RISC-V用户指定在处理器运行时要追踪哪些定制指令,以支持这种可调试环境。我们也是RISC-V组织的成员之一,几年前我们捐赠了高效追踪(E-Trace)规范。那是一种高度压缩的指令追踪,面向复杂系统,因为那里会有大量数据,因此我们也需要考虑如何压缩这些数据。在我们的基础设施中,关注的不只是处理器,而是整个系统。因此,我们的基础设施可以捕获来自RISC-V核心的指令追踪,也可以捕获来自RISC-V SoC各个部分的追踪,例如互连、总线监控,或者我们想监测的特定信号。
Leiss:我们已经谈了很多关于验证定制指令集、通过ISA级验证的问题,而且大多数时候,生成的IP可能会附带验证材料,比如测试平台、流量生成器和性能模型。但我从系统角度看,这意味着一个高性能系统里通常有多个核心,而当你在RISC-V五核里放入一个加速器,或者在一个系统里放入多个RISC-V时,你会立刻遇到一致性问题,因为你会用到缓存等等。一致性边角案例和流量突发很容易导致fabric死锁。因此,从NoC角度出发,我们必须在系统层面做所有这些验证,检查流量如何通过,并确保不会陷入死锁。简单来说,某条指令可以正确执行,但如果这条指令或计算所需的数据突发不可用,芯片仍然可能失败。这正是我们正在解决的问题。
Ann Mutschler