纽约,2026年10月27日 /PRNewswire/ -- 专注于AI皮肤智能和个性化护肤的SaaS技术公司Haut.AI今天发布其皮肤基础模型Skin Foundation Model(SkinFM)。这是一款基于图像的AI基础模型,使用超过400万张真实皮肤图像训练而成,可帮助公司更快开发定制化的皮肤测量和分析能力。
Haut.AI还发布了SkinBench,这是一项新的公开基准测试。公司表示,该测试显示,包括来自Google、OpenAI和Anthropic的模型在内的六个领先AI模型,经常会识别出并不存在的皮肤问题,或者无法识别实际存在的问题。Haut.AI称,虽然流行AI模型可以识别人脸并描述可见特征,但SkinBench结果表明,它们在准确评估皮肤方面可能存在困难,从而可能导致不准确的皮肤评估和推荐。
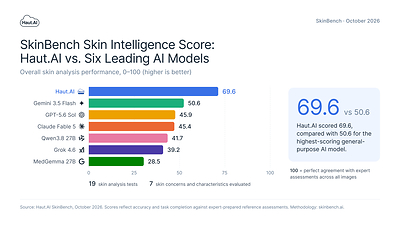
Haut.AI与六个领先AI模型在SkinBench上的表现
在Haut.AI新公开的SkinBench基准测试中,六个领先AI模型——包括Google的通用模型Gemini 3.5 Flash、OpenAI的GPT-5.6 Sol、Anthropic的Claude Fable 5、xAI的Grok 4.6、阿里巴巴的Qwen 3.8 27B,以及Google的医学专用多模态AI模型MedGemma(27B)——在约95%至100%的未出现眼部浮肿的图像中,错误识别出了眼部浮肿。
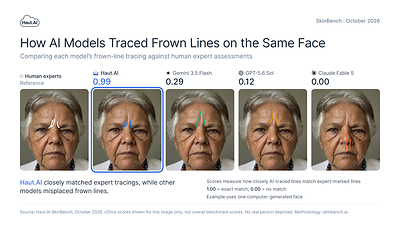
这些模型在识别皱纹和判断肤质类型(如干性、油性或混合性)方面也表现不佳。当被要求在脸上标记皱眉纹时,一个领先模型把鼻子和嘴巴标了出来,另一个则在测试图像上没有画出任何线条。
相比之下,Haut.AI的模型识别出了82%的深额头皱纹,而其他模型的识别率在15%至60%之间;其平衡准确率为78%,而其他模型为37%至58%。平衡准确率对每种肤质给予同等权重。
总体而言,Haut.AI的技术在SkinBench皮肤智能评分中获得69.6分(满分100分)。该评分衡量皮肤分析准确性和任务完成度,100分代表与专家对每张图像的评估完全一致。相比之下,得分最高的通用AI模型Gemini 3.5 Flash得分为50.6分。
为何护肤需要专门为皮肤分析打造的AI
随着企业越来越多地转向为特定行业和任务设计的AI,而不是完全依赖领先的大模型,这些结果也随之出现。Gartner在2025年4月预测,到2027年,企业使用小型、专用AI模型的频率将至少是通用大语言模型的三倍。
NielsenIQ发现,49%的消费者曾接受过生成式AI提供的美妆产品推荐。对这类工具的依赖正在加深:Accenture发现,75%的美妆消费者表示愿意接受AI驱动的购物体验。这种开放态度也延伸到护肤领域。Haut.AI对1238名美国女性的调查显示,62%的美国女性对使用AI获取护肤或身体护理建议感兴趣,或已经在使用AI;其中一半受访者表示,她们会信任AI提供的身体护理产品推荐。
Haut.AI首席执行官兼联合创始人Anastasia Georgievskaya表示:“AI可以识别人脸,但这并不意味着它能准确评估皮肤。我们的研究结果显示,当今一些领先AI模型经常会检测出并不存在的皮肤问题。随着消费者越来越依赖AI获取护肤建议,这确实令人担忧。我们开发SkinFM,是为了让皮肤分析更准确;我们创建SkinBench,则是为了让行业能够看到不同AI模型的真实表现。”
SkinFM的作用:面向美妆品牌的皮肤分析基础模型
与需要为不同皮肤分析任务分别训练模型的传统AI系统不同,SkinFM采用单一的基于图像的AI基础模型来分析多种皮肤特征。这种方法也使Haut.AI能够更快开发新的皮肤测量指标,并创建可根据不同品牌需求定制的分级体系。Haut.AI的技术可评估230多项皮肤测量指标和48项生物标志物,包括皱纹、泛红、色素沉着及其他可见皮肤特征。
对于美妆品牌而言,这意味着它们可以根据自身产品和客户需求定制皮肤评估,更快推出新的测量指标,提供更有针对性的个性化推荐,跟踪可见改善随时间的变化,并支持护肤研究和产品开发。
SkinBench结果:六个领先AI模型在皮肤分析中的表现
SkinBench将Haut.AI的专用皮肤分析技术与Gemini 3.5 Flash、GPT-5.6 Sol、Claude Fable 5、Grok 4.6、Qwen 3.8 27B和MedGemma 27B进行比较。该基准由Haut.AI的数据科学团队开发,围绕七类常见皮肤问题和特征进行19项测试:皱纹、晒斑、泛红、肤色、肤质、黑眼圈和眼部浮肿。其中11项测试用于识别和分级可见皮肤特征,8项测试用于衡量模型定位这些特征的准确性。结果与专家准备的参考评估进行对比。
以下五项SkinBench发现显示出性能差异有多大,以及这些差异为何重要:
- 专用AI在一项特定的皱纹评估中最接近人类专家。Haut.AI在皱眉纹严重程度与专家评估的一致性上得分为0.82,GPT-5.6 Sol为0.73,人类分级员为0.86。基于350张计算机生成的人脸,这一结果表明,专用AI在某些界定明确的皮肤分析任务上可以接近人类水平的一致性。
- AI经常检测出并不存在的皮肤问题。正如眼部浮肿结果所示,不准确的AI皮肤评估可能导致不必要的产品推荐、浪费支出,并削弱消费者对美妆品牌个性化护肤服务的信心。
- 识别皱纹并不等于准确定位皱纹。当被要求在350张合成面孔上描绘皱眉纹时,Haut.AI得分为47.8分,GPT-5.6 Sol为20.2分,是表现最强的竞争模型。差异之所以重要,是因为品牌需要知道皱纹位于何处,才能衡量变化并评估产品效果。
- AI模型在肤质分类上的一致性较差。Haut.AI在肤质分类上得分77.8分,而表现最强的竞争模型为57.7分。错误识别某人的肤质可能影响保湿霜、洁面产品及其他护肤品的推荐。
- 不同肤色之间的准确性存在差异。Haut.AI在不同肤色上的表现得分为50.9分,而次优通用AI模型为30.3分。该评分聚焦于每个模型表现最弱的合格肤色群体,凸显品牌需要确保其技术对不同肤色消费者都能稳定可靠。
Haut.AI并未在每一项测试中都胜出。例如,Gemini 3.5 Flash在鱼尾纹评分方面表现更好(71.7分对61.8分),在肤色评估方面也更好(90.4分对87.6分)。这些结果进一步说明,评估AI工具时应针对其预期执行的具体任务,而不是只看单一总分。
SkinBench的公开排行榜为不同皮肤分析能力及不同肤色上的表现提供了单独评分,方便企业根据自身最相关的能力比较模型。
Haut.AI计划继续扩展SkinBench,纳入更多AI模型,并增加新的测试,以检验模型在分析同一皮肤问题时是否会给出一致结果。
Georgievskaya表示:“随着AI在美妆领域越来越普遍,品牌需要证明支撑其推荐的技术能够提供可靠结果。错误检测不仅是技术失误,还可能导致不恰当的产品推荐、不必要的购买,以及消费者信任流失。我们的目标是为品牌提供所需证据,帮助它们选择能够赢得并维持消费者信任的AI技术。”
SkinBench排行榜、模型对比和测试方法可在skinbench.ai查看。
提供给新闻媒体的图形资料
Haut.AI为报道SkinBench基准测试的新闻媒体提供配套资料,包括展示关键发现的图形和详细说明AI在特定皮肤评估中表现的HTML报告:
- 图形(4张):四张图形突出展示了基准测试的关键发现,包括AI模型在识别皮肤问题、识别皱纹、分类肤质以及评估不同肤色准确性方面的表现。
- HTML皮肤评估示例(8份):八份详细的HTML报告比较了AI模型在评估具体皮肤问题时的表现,包括眼下细纹、鱼尾纹、黑眼圈、眼部浮肿、额头纹、眉间纹、唇纹和晒斑。每份报告都提供了可视化对比、性能指标和详细结果,展示不同AI模型之间的差异。
全部12项资源均可用于编辑用途,并可在此下载。
关于Haut.AI
Haut.AI是一家专注于AI皮肤分析和个性化护肤的技术公司。公司由科学家和AI创新者创立,开发先进的皮肤智能技术,帮助美妆和健康品牌在不同肤色和身体部位上测量并理解皮肤特征。Haut.AI的技术建立在超过2000万张图像之上,其专利图像匿名化技术在保留分析所需皮肤数据的同时,保护可识别的面部信息。Haut.AI与Neutrogena、Beiersdorf、Ulta Beauty和Grupo Boticário等全球领先品牌合作,提供以科学为基础的个性化护肤体验,以增强消费者参与度并推动业务增长。公司获得了战略投资者支持,包括Ulta Beauty旗下Prisma Ventures、Grupo Boticário的风险投资部门以及LongeVC,并参与了Microsoft for Startups和Google的Gemini Startup Forum。更多信息请访问haut.ai。
媒体联系人:Michael Tebo,Gabriel Marketing Group(代表Haut.AI),电话:571-835-8775,邮箱:[email protected]