















随着企业越来越多地转向AI代理来自动化工作,锁在复杂文档中的海量信息仍然是一个难题。Unsiloed AI已完成750万美元种子轮融资,由Felicis领投,目标是通过专门技术帮助企业让文档更容易被AI代理访问和使用。
这轮融资由硅谷风投公司Felicis领投,Y Combinator、Orange Collective和Uncorrelated Ventures参投。天使投资人Aarthi Ramamurthy和Beth Turner也参与了投资。
商业文档通常包含表格、图表和复杂排版,AI系统往往难以准确解读。但如果信息出错,企业可能付出高昂代价;对于银行、医院或律所而言,风险尤其严重,因为它们日常工作都依赖这些文档。
Unsiloed的目标是用软件解决这一问题。该软件会拆解复杂文档,提取表格、图表和其他元素中的信息,并将其转化为AI代理可使用的结构化数据。该技术还会显示提取信息在原始文档中的来源,方便企业核查结果,而不是直接接受AI输出。
“LLM的问题在于它们本质上是概率性的,”Unsiloed联合创始人兼首席执行官Aman Mishra在采访中说,“它们会带来一定偏差,也会出现幻觉,而这会在下游造成巨大的负面影响。”
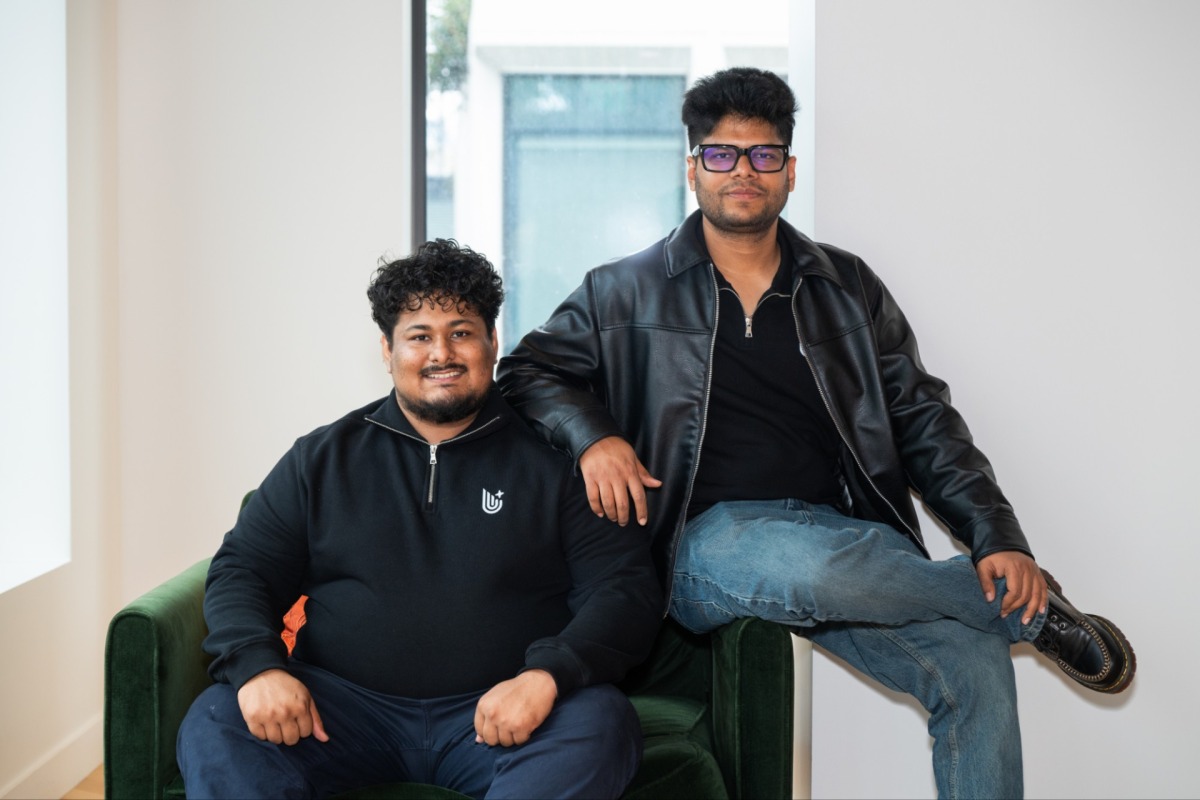
Mishra与Adnan Abbas共同创立了Unsiloed,后者是他在印度理工学院(IIT)克勒格布尔分校的前同学。两人在开发这项技术一段时间后,加入了Y Combinator 2025年秋季批次。
Mishra告诉TechCrunch,Unsiloed已经在金融、法律服务和医疗保健领域与客户合作。一家银行正在使用其技术处理文档,一家律所则将其部署在自有服务器上处理合同和旧案卷;他没有透露这两家客户的名字。不过,Mishra提到了语音AI初创公司Bolna AI,称其使用Unsiloed来摄取知识库,以构建语音代理。
这家总部位于旧金山的初创公司进入的是一个已经相当拥挤的市场,其中包括Reducto和Unstructured等专门的文档处理初创公司,以及微软和亚马逊提供的相关产品。企业有时也会使用通用AI模型从文档中提取信息,这也让Unsiloed面临另一批竞争对手。
Mishra告诉TechCrunch,Unsiloed的优势在于其处理复杂文档的方式。该公司使用其称为“双流”视觉模型的技术,将文本和图像数据分开处理,并采用一种名为“基于热力图的分块”的技术,帮助识别文档中最重要的部分。
“在其中一个流里,你会有文本token;在另一个流里,你会有精确的图像token,”Mishra说,“这是我们花了很多时间进行架构设计的东西。”
随后,这项技术会将更多算力导向图表、数字和图形等区域。Unsiloed还使用一种专门的解码器,会考虑行业特定术语,帮助它区分在不同商业语境中可能含义不同的词语。
为支持这些说法,Mishra提到了一项测试:一家企业客户提供了542份金融文档。根据该初创公司分享的技术简报,Unsiloed在约8.4万个提取数据点上实现了99.78%的准确率。测试将Unsiloed与主要AI模型、微软Azure Document Intelligence以及客户自研的提取工具进行了比较。不过,这些结果尚未经过独立验证。
Unsiloed还表示,在Allen AI开发的公开基准olmOCR-Bench上,其表现优于竞争对手的AI文档处理工具。根据该公司进行的测试,Unsiloed得分为88.0,而Reducto的agentic系统为66.0,Unstructured为39.9。该基准覆盖1,403页PDF,测试系统处理表格、数学表达式、扫描文档和复杂版面的能力。
Mishra表示,Unsiloed的定价从每页1美分起。他称,该公司的方法还通过将算力集中在文档最需要关注的部分,帮助降低成本,而不是以同样方式处理每个部分。
目前,Unsiloed共有7名员工。Mishra说,公司计划利用这笔新资金招聘更多研究人员和工程师,扩大销售力度,并开发专有数据集以改进技术。