Dintlha tsa botlhokwa:
- 為嵌入式應用匹配合適的 AI 模型,第一步是明確用途,包括目標設備功能及產品特性。
- 設計者通常會組合使用多種壓縮技術,而不是只使用一種方法。常見的策略包括量化(quantization)、蒸發(distillation)和剪枝(pruning)。
- 小型語言模型(SLM)和緊湊型邊緣模型需要緊密的系統級集成,才能實現最佳效率。
如今的 AI 行業面臨兩種截然不同的挑戰。一方面是龐大的 AI 資料中心與 AI 工廠,它們正在尋求更高效的方法來處理高參數的大型語言模型(LLM),其中帶寬與內存是關鍵的瓶頸。另一方面則是在邊緣設備上運行的小型 AI 模型,這些設備沒有足夠的空間、功耗或內存來承載複雜、參數更多的 LLM。
Imagination Technologies 首席技術官 Ed Plowman 表示:「這引發了一場淘金熱,人們籌集了巨額資金去建設超大規模的数据中心,但這也推動了邊緣側的創新。人們正試圖弄清楚如何將整個集裝箱的液體塞進一個很小的杯子裡,而這背後的驅動因素是,現在計算資源並非主要問題,帶寬才是。這就是為何 RAM 变得如此昂貴。這又促使一大批研究人員去尋找關鍵問題是什麼,以及我們能做些什麼。由此催生了圍繞量化的創新——同時減少激活值和權重——以便讓模型更小,同時仍保持模型的輸出能力。」
AI 模型有各種形態和尺寸,以適應從耳機、手機、家電到工業物聯網、機器人和汽車系統等廣泛的邊緣設備。設計者需要選擇參數數量適當的模型,因為模型過大可能會拖慢設備速度,甚至導致過熱。反之,如果模型太小,產品可能又不够智能。
為嵌入式應用程式匹配 AI 模型的第一步,是定義它的用途。 Plowman 說:「你必須從『模型要完成什麼功能』這個角度出發,但我們也可以用一百零一種方法來讓它變得更小。量化和自壓縮都非常有效。『蒸餾』(distillation)也是其中的一種方法,而且它在 Transformer 上的效果通常比在傳統的卷積神經網路(CNN)上更好。所有這些方法正在被結合起來,讓『更大更強的 GPU』的熱潮不再那麼盛行。在嵌入式系統中讓模型擁有更強大的功能,以及讓相當智能的模型能夠在真正的嵌入式平臺上運行,這件事正變得越來越現實。」
圖1:AI 模型常見壓縮方式
模型大小必須與系統一起考慮。Imagimob(英飛凌科技旗下的公司)首席技術官兼首席產品官Magnus Gedda表示:「難點在於,既要設計出夠複雜、能夠解決問題的模型,又要讓它夠小,能夠裝進設備裏。除此之外,模型通常還需要與應用的其他部分共享內存和算力,所以可用資源比規格表上顯示的更少。剪枝和量化等優化技術可以縮小模型,但它们通常是在設計之後、往往也是訓練之後才應用,而且會損失一些精度。你需要從一開始就選擇合適大小的初始架構,這樣優化後的版本仍能裝進設備,並滿足性能目標。讓這三件事對齊——問題匹配、尺寸合適、優化後的精度——是大部分工作量所在。」
其他人也認為,系統級效率是核心挑戰。Rambus 杰出發明家兼研究員 Steve Woo 表示:「邊緣 AI 正在推動一種轉變,即從『最大模型贏得比賽』轉向『每瓦特體驗』。壓縮、剪枝和低精度算術等技術有助於縮小模型,使其適配本地資源,但部署仍然困難,因為內存容量和帶寬往往是限制因素。把模型放到設備上只是開始。如何在嚴格的功耗和延遲預算內高效運行,才是工程挑戰真正開始的地方。」
如果選錯了 AI 模型,部署後可能會帶來額外的工作,或者導致產品表現不佳。Gedda 說:「一旦你有了優化後的模型,部署其實並不難。模型會被轉換成 C 代碼,為目標平台編譯,然後刷寫到設備上。真正的挑戰在於充分發揮硬件的潛力,讓推理既節能又低延遲。邊緣硬件的種類極其繁多——MCU、加速器、NPU、DSP——而且標準還不夠完善。因此,如果沒有合適的工具,你最終要么得到一個通用但效率低下的部署,要么為每個目標平台做大量的手工工作。」
這些部署約束使得模型選擇成為一項與具體應用高度相關的工作。合適的架構取決於設備必須執行的功能,以及它需要支持的工作負載。
Cadence 芯片產品營銷高級總監 Mick Posner 在最近的一篇博客中指出:「物理 AI 的右尺寸化推理至關重要。智能物理系統並不存在一種放之四海而皆準的計算配置。有些工作負載需要始終在線、低功耗推理;另一些則需要跨攝像頭、雷達、激光雷達、音頻、環境傳感器和系統狀態數據進行更高性能的多模態處理。」
每一項硬體功能與終端設備的特性都需要被考慮和定義。西門子 EDA 的 EDA AI 產品負責人 Sathish Balasubramanian 表示:「為邊緣 AI 配置合適模型的最佳技術之一,就是能夠對功能進行分類,這樣你就不需要一個大模型了。一個有40億參數的模型放在感應器上已經很大了,雖然現在我們在雲端談的是1萬億參數的模型。將這個模型壓縮到10億參數以下,並部署到每個感應器裏,是可行的。我們需要定義最高優先級、必須具備的功能,並在 SLM (小型語言模型)中把它訓練好。它甚至可以是一個 ML (機器學習)模型或神經網絡模型,不一定是 LLM。」
在定義好必須具備的功能之後,設計者就可以開始構建 AI 核心,然後逐步加入更多功能,包括必須具備的、關鍵的或錦上添花的功能。
Balasubramanian 說:「從架構的角度来看,我發現人們通常會定義這三類功能,以及它們是如何承載智慧的。一旦你確定了這些類別,那麼必須具備的功能就應該盡可能地靠近感測器。你不能把所有東西都設定為必須具備的。你真的需要進行優先排序,並以一種讓系統能夠在自包含的感測器閉環中運行的方式來設計它,這意味著需要本地計算、本地存儲需求,有時甚至還需要本地備份環境。所有的一切都被分開了。你還需要至少一到兩小時的電力餘量,這樣裝置才不會降速或關機。」
在汽車領域,企業越來越多地將AI模型用於特定任務和功能,不過該行業在很大程度上仍在使用三四年前的CNN。Plowman指出:「他們還沒有完全轉向Transformer,也沒有採用最新的壓縮技術。但某些外部機構已經推出了圖像分割和目標識別系統,這些系統使用的是Transformer。」
對於負責優化這些模型的 IP 供應商來說,一個挑戰在於,他們可能無法看到客戶實際使用的模型。Plowman 說:「汽車製造商會訓練自己的模型,而且出於安全、保密和專有 IP 的原因,他們對這些模型非常保密。我們無法看到它們。我們會得到很多關於它們外觀的代理信息,或是他們希望我們加速的代理功能,但我們很少能拿到整個模型來研究。」
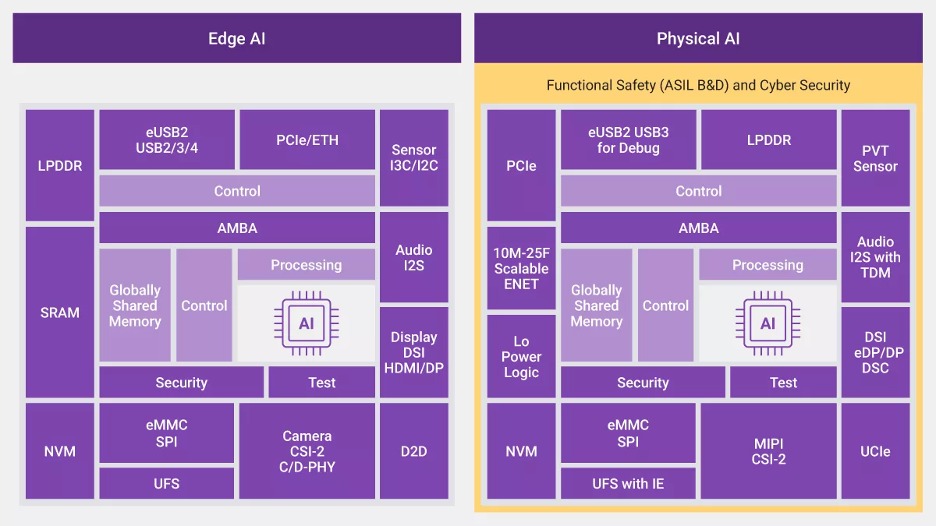
圖2:邊緣 AI 與物理 AI 的 IP 模塊。來源: Synopsys
在進行右邊尺寸調整時,每個 IP 模塊都需要與模型大小一起權衡。Synopsys 產品管理高級總監 Licinio Sousa 表示:「為邊緣設備進行右邊尺寸調整模型是一個系統問題,而不是單點優化。量化等技術有助於讓模型裝下,但實時延遲、功耗、成本和功能安全都必須一起平衡。隨著 AI 模型的演進速度快於芯片開發週期,系統還需要足夠的靈活性,不僅要支持今天的工作負載,也要支持下一代模型。」
當模型與系統架構對齊後,設計者必須確定哪些壓縮技術能在不犧牲關鍵精確度或性能的前提下滿足這些約束。
各種壓縮技術的挑戰
設計師通常會使用多種壓縮技術來為模型進行尺寸調整,每種方法都有其優缺點。
例如,蒸馏可以大幅縮小模型,但也可能帶來更多損失。Plowman 說:「你會去審視模型,找出哪些部分被激活。你會做類似的工作,把一些東西裁掉,但師生模型總會有損失。學生模型試圖從大模型中提煉出教師模型知道的核心內容。這就是為何它可能帶來更多固有損失,但你可以保留更多推理能力。它能大幅縮小模型尺寸,但如果不進一步做量化,你能走的路也有限。」
量化會讓模型以一種更迂迴的方式達到目標,而不是直線前進。Plowman 說:「當將輸入施加到網絡時,會有一個起點。然後,根據你給它的數值,你需要導航到一個終點。每經過一層,你都在將變換朝着稍微不同的方向推動。使用 FP32 或 FP16 這類全精確值時,你會更直接地達到某個點。」
全精度值就像直线飛行,而量化則更像是城市街區式的導航。Plowman 說:「我們向上走一步,向右走一步,再向上走一步,再向右走一步,但最終你會到達完全相同的位置。量化的訣竅在於,讓這些更小、更帶有角度的步驟表達出與直接導航相同的含義,同時避免相關數學運算帶來的功耗、內存和其他成本。它一開始會取得模型中的所有權重,然後將它們裝入與量化相匹配的『桶』中。量化有很多很多不同的方法。這是一種非常粗暴的做法。」
更溫和的方法是自壓縮。Plowman 解釋說:「自壓縮技術意識到,在模型訓練過程中,某些路徑會非常熱門,而其他的一些則不那麼熱門。你永遠不知道這種維度形狀最終會是什麼樣。每次重新訓練時它都是隨機的。你可以操控這個空間,讓某些你想要的形狀每次都能重現,或者至少接近它們,但其中存在隨機性。你會得到一些路徑,它們成為系統其他部分的支架,但這些路徑最終並不重要。我們會尋找這些路徑的敏感性,然後將它們量化、再量化,直到變成零比特。如果模型沒有任何變化,而你仍然得到相同結果,那麼這些路徑的貢獻很可能非常小,甚至可以忽略不计。」
圖3:量化後的 Transformer 架構。來源: Imagination
對於量化和自壓縮來說,複雜性在於如何管理損失。Plowman 指出:「你需要確保沒有丟失真正需要的事物,並且在訓練集中有足夠好的數據覆蓋來支持量化流程。」
歸根結底,成功的邊緣 AI 部署始於定義工作負載並選擇合適大小的架構,而不是簡單地縮小現成的最大模型。壓縮可以幫助彌補剩餘的差距,但其價值取決於是否能在滿足設備功耗、內存、延遲、成本和安全要求的同時保留精確度。隨著模型和硬體以不同的速度演進,靈活的系統設計將成為支持當前應用和未來工作負載的關鍵。
參考資料
- 《結構化與非結構化剪枝:指數級差距》(蔚藍海岸大學、倫敦國王學院)
- 《自壓縮神經網絡》(Imagination Technologies)
Can Edge AI Keep Up ? 隨著模型演進速度超過芯片週期,專家們正在權衡架構師能在多大程度上保持適應性,而不犧牲功耗、面積或效率。
__BJW_BOLOKA_00001__