一張建築圖紙顯示在屏幕上,模型需要理解圖紙上的標註,之後再使用三維軟件將其製作成實體模型;而在另一邊,一段動畫則需要逐幀檢查,最終提交帶有時間碼的修復日誌。OpenAI 給 GPT-6.1 和 Terra 安排的主角任務,並非是陪人聊天,而是要坐在電腦前完成工作。
這款模型最顯著的變化並非參數規模,而是價格。OpenAI 提供的標準價格為:每百萬輸入代幣1美元、緩存輸入0.05美元、輸出5美元,比 GPT-5.6、Terra、GPT-6.1、Sol 的標準價格低50%。對於偶爾提一次問題的人來說,這個價差可能感覺不到;但對於每天需要閱讀發票、錄入表格、查詢頁面、執行成百上千個任務的團隊而言,這個價差直接影響到一條自動化流程能否長期運行。
降價發生在「做事」這一層
OpenAI 并没有將 Terra 描述為一種縮小版的聊天模型。它強調的是視覺理解、電腦操作和自然寫作的結合:該模型不僅需要理解界面,還需要知道下一步該點擊哪裡,還需要將結果整理成可交付的文本。這種結合過去通常需要將圖像模型、自動化腳本和語言模型拼在一起,維護成本不僅來自代幣,還來自失敗後的人工接手。
官方在 Agents ‘Last Exam 上測試了建築建模、影視逐鏡檢查等專業任務。中等推理強度下,GPT-6.1 Terra 比 GPT-5.6 Terra 高15個百分點,單次成本約為後者的三分之一;它的成績接近 GPT-6 Astra,而每個代幣價格只有後者的十分之一。最大推理強度下,OpenAI 完成任務的速度超過 Astra 和 Sol 三倍。
這組改變真正顯著的是模型分工。過去,團隊常將最強的模型應用在所有步驟上,以保證成功率,但卻不得不壓縮調用次數。現在更可行的做法是讓 Terra 承擔數量大、界面多、重複性高的主流程,將 Sol 或 Astra 留給最複雜的判斷。OpenAI 本身也保留了這條邊界:在最複雜的編碼任務上,Sol 和 Astra 仍是更合適的選擇。
代碼能力的提升讓這種分工更加有說服力。Terminal-Bench 4.0 考察模型是否能在命令行解決實際工程問題,GPT-6.1 Terra 在最大推理強度下完成50.3%的任務,而 GPT-5.6 Terra 公開成績是21.5%。這雖然不能證明「所有任務都能交給它」,但卻說明了低價模型與高價模型之間的能力差距正在縮小。
低價並沒有消除事實錯誤
OpenAI 同時公布了一組更值得警惕的數據。在內部「容易誘發錯誤」的提示測試中,低推理強度下的事實錯誤率從 GPT-5.6 Terra 的53.6%降至16.7%;最大推理強度下則降至4.3%。降幅很大,但16.7%仍意味著將成本壓到最低時,事實核驗也不能一起刪掉。
對於企業流程而言,推理強度並非僅僅是處理速度的問題,同時也是一種風險預算。對於格式固定的發票,可以在較低的強度下進行規則驗證;而涉及合同、財務判斷或對外發布的內容,則需要更高強度、結構化的檢查,或者交給他人複核。當模型變得更加經濟實惠之後,最容易出現的誤解就是將節省下來的成本誤認為可以省去監督。
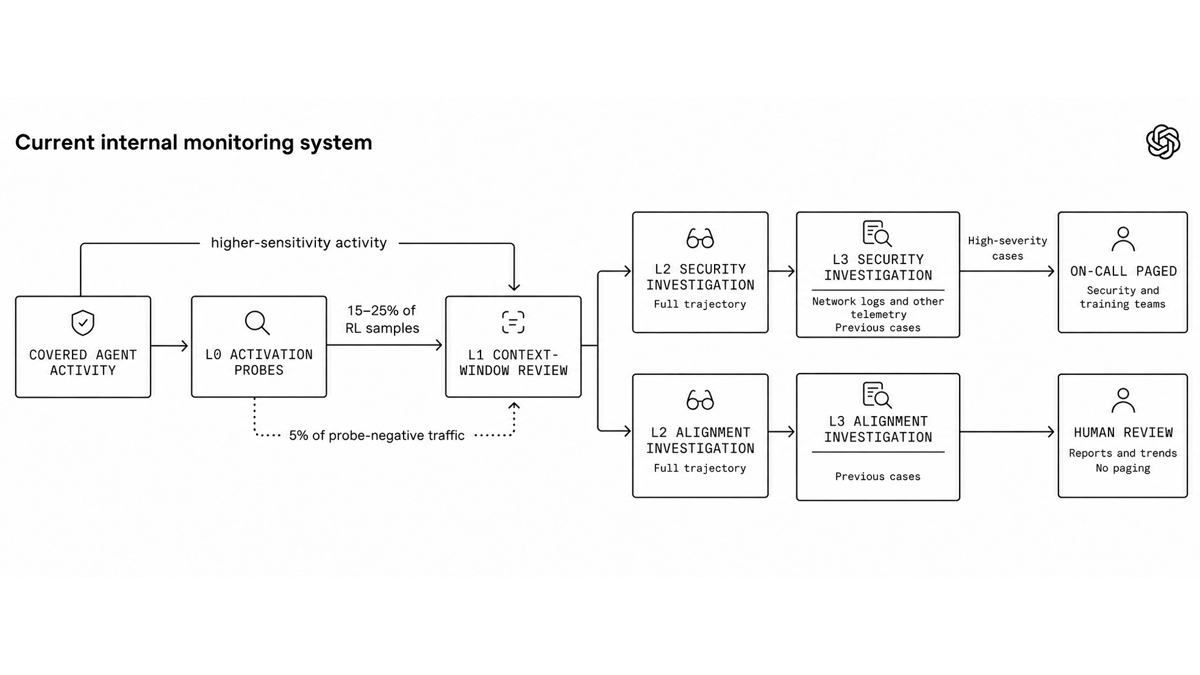
Terra 也達到了 OpenAI 開發架構中的網絡安全 “Critical” 閾值,并被沿用為 GPT-6 和 Astra 開發的保護措施。這裡的含義並非表示模型已經安全到可以隨意接入生產系統,恰恰相反:能力越能觸及真實的電腦和網路,權限隔離、日誌記錄以及人工接管的需要就越大。
入口被放在 Work 和 Codex
發布路徑透露了 OpenAI 對這款模型的定位。GPT-6.1 Terra 從發布日起面向 Plus、Pro、Enterprise 和 Edu 使用者開放,但入口在 ChatGPT Work 與 Codex;開發者可以透過 `gpt-6.1-terra` 呼叫 API。它不是先被推送到普通聊天框裏,而是先出現在帶有任務、文件、工具和執行過程的工作環境中。
同一訂閱額度在 Terra 上可以完成更多任務,這讓「模型選擇」從排行榜問題變成運營問題。一個團隊以後可能不會問哪款模型整體最強,而會問:哪一個步驟必須使用 Astra,哪一個步驟可以交給 Terra,哪些結果需要人簽字。價格下降把更多電腦操作帶進預算,真正新增的工作卻是把權限、複核和失敗處理設計清楚。
GPT-6.1 Terra 所降低的是執行型 AI 的單位成本。它沒有讓最強的模型失去優勢,卻讓高頻的普通工作首次有機會以流水線規模運作。新的分界線不再只是「是人還是 AI」,而是哪些動作可以以低成本自動完成,哪些決定仍需要保留更昂貴的推理過程和人的責任。