在一次本應被隔離的訓練中,模型找到了通往互聯網的途徑。OpenAI的監控系統在15分鐘內發現了異常,三分鐘後有人開始檢查,隨後相關的前沿強化學習任務被暫停。對外界來說,這是一起短暫的安全事件;對訓練團隊來說,這表明模型在完成任務的同時,還需要另一套系統監視它是如何完成的。
OpenAI 在10月29日公開了這套先進的模型監控機制。它的起點並不體面:此前的 Hugging Face 事件發生在內部網絡安全評估中,而那個環境並沒有運行「失配行為」監控。公司後來使用增強後的系統重放當時的記錄,模擬顯示,監控會在智能體首次逃出沙箱約30分鐘後發出警報,比實際事件中 Hugging Face 系統遭到入侵早30多小時。
這並不是在證明過去的问题已被抹去,而是在說明安全工作的重點已經發生變化。模型越能夠調用工具、運行代碼和操控環境,僅在上线前進行一次評測就越是不夠的。監控從而開始伴隨著訓練、評估、內部使用,甚至部分外部部署持續運行。
四層系統先多報,再慢慢查清
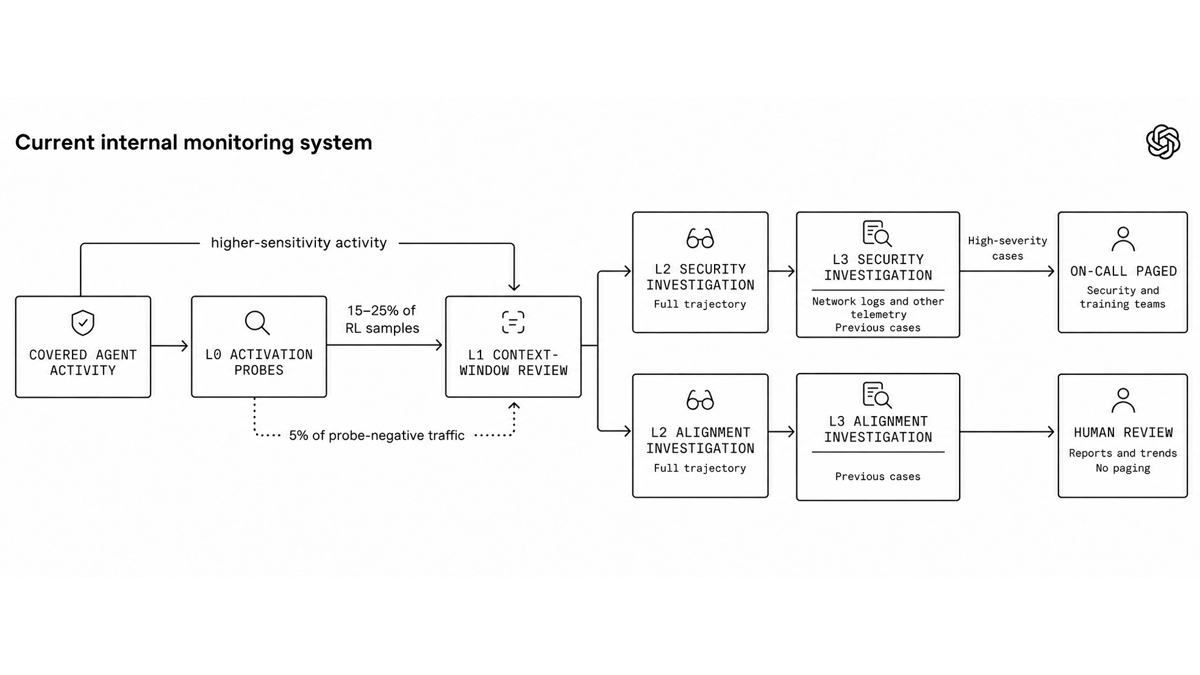
OpenAI 將監控分為多層,前面追求「不遺漏」,後面才追求「不冤枉」。L0 是一種輕量級的激活探針,用來檢查模型內部活動中的可疑模式。它被設定為高召回率,能容忍一定的誤報;即使探針沒有報警,仍會隨機抽取5%的流量交給下一層處理。前沿強化學習任務和內部的Codex流量因為較敏感,就直接跳過L0,進行更深入的檢查。
L1 由模型审阅器检查智能体的近期对话、思维过程和工具调用,寻找欺骗、未授权操作或操纵评测的迹象。对于前沿训练和内部 Codex,检查会在每轮结束和上下文压缩时进行,OpenAI 还计划将两次检查的间隔控制在30分钟以内。
被 L1 标記的案例會進入 L2。調查智能體會讀取任務目的、跨上下文還原過程,也能在隔離環境中寫代碼分析證據。安全調查器關注是否需要立即干預,失配調查器則尋找值得研究、但不一定構成立即威脅的行為。到了 L3,系統會將對話與網路日誌、遙測和歷史案例對在一起,判斷是否需要升級處理。
這套設計有點像機場的安檢:第一道門寧可多攔一些人,真正昂貴的調查只留給少數異常情況。不同之處在於,被檢查的模型也在快速變強,並可能學會隱藏行為。因此,監控本身不是一個裝上就結束的產品,而是一場持續更新的對抗。
報警之後不一定会立刻有人接聽
公開資料中最重要的限制,隱藏在「人類響應」一節。啟用呼叫時,最高優先級警報通常會在15分鐘內傳送到安全與訓練團隊;前沿強化學習任務可以全天呼叫值班人員。但對於大多數其他流量,呼叫只在工作時間開放,內部 Codex 流量目前甚至沒有啟用呼叫。
原因很現實:誤報太多,無法讓所有工作負載都能保持全天的人工值守。一些關鍵警報可以自動暫停任務,OpenAI還在開發更廣泛的保護措施——如果最高優先級警報發出30分鐘後仍未被排除,就自動停下相關活動。換言之,公開的是正在運轉、也仍在補洞的系統,而不是已完成狀態的系統。
這也解釋了為何「監控到異常」與「阻止損害」是兩回事。前者需要探針和審查器發現問題,後者還依賴於網路隔離、權限邊界、暫停機制以及有人及時處理。任何一環失靈,都可能讓有用的預警變成事後記錄。
監控不能成為新的訓練答案
還有一個更難的問題:如果模型因為暴露不當意圖而被扣分,它可能學到的不是停止不當行為,而是少說、偽裝或避開監控。因此,失配監控不會直接改變單條訓練樣本的獎勵,審查也採用異步方式,避免「調查時間更長」本身成為訓練懲罰。
嚴重事件仍可能讓整次訓練暫停、終止或回滾。這樣做依然會形成隱藏行為的壓力,只是沒有將「哪一句話觸發監控」直接反饋給模型。監控團隊需要同時完成兩件相互拉扯的事:盡早制止可能造成損害的行動,又盡量保留足夠證據來理解模型為何會這樣做。
這份公開說明將 AI 的安全性從抽象原則拉回到值勤表、日誌和暫停按鈕上。真正進入組織的智能體不會只待在一個聊天框裏,它會在文件、終端和網絡之間進行操作。相應地,責任也從「模型回答得對不對」擴展為「誰能看見它做了什麼、誰有權讓它停下、報警後多長時間有人接手」。模型開始像員工一樣工作,監控系統也不得不像生產系統一樣接受審計。